(一)
我并非程序员,而是做财务、战略、PR/GR、企业经营管理工作。不过现在我们几乎有80%的工作都实现了Agent化,可以做到以前都不能做、甚至不敢想的事情。
这些变化,都不是使用哪个模型、哪个软件就能完成的。
我过去一年最重要的AI实践和理念,就是Workspace as an Agent。
一个Workspace其实就是电脑上的一个文件夹,让AI进入并且管理这个文件夹,持续建立、维护一个长期存在的文件目录。这个目录下不只是原始输入和输出文件,还包括对这些文件之间关系的记载、对于任务完成过程的日志记录、对于目标和意图的理解。最终不断沉淀出结构化的索引和更高维度的知识。这个目录只要接上AI模型,加上token,就拥有了完成任务的智能,Workspace就成了Agent。
我做的事情说起来也很简单,不需要复杂的AI软件和配置。就是把AI请进我的电脑,请进我的工作目录里。
(二)
具体步骤如下。
第一步,在自己的工作电脑上,安装Codex / Claude Code(以下提到Codex的地方,基本换成Claude Code也一样)。。
第二步,当开始执行一个任务的时候,在本电脑里新建单独的文件夹,启动Codex / Claude Code这类agent,输入提示词
“[你是XXX角色],[你要处理xxxx任务] ,把当前目录作为agent workspace. ”
这样agent就可以开始初始化。agent开始工作就会在文件夹中写入各种agent.md, readme.md等文件。随着agent开始工作,它会逐步在文件夹中新建各种文档、脚本、input、output等。这个workspace里的内容会越变越多。
以后的每一次,要执行同一类任务时,仍然回到这个文件夹,启动Codex或者任意一个本地Agent,开启新对话。不要认老的对话session,换AI Agent也不要紧,就认准文件夹。
有几种常用的(且看起来很日常的)提示词。
1. 复盘下刚刚为什么出错,确保未来不再犯
2. 整理下workspace
就这样,Over.
(三)
举个例子。
我要管理办公室的某类资产,但是我们没有合适的ERP。
我并没有让Codex给我写一个资产管理软件。
我在本机建了一个文件夹叫做“某某Assets”,打开codex, 说“我要管理办公室的某类资产,登记资产的状态信息以及变动情况,以及在资产到期之前及时提醒我处理,请把当前目录作为agent workspace.”
Codex开始初始化,我用typeless把现在资产的现状口喷了一遍。现在的资产信息非常零碎也很少,但是我把我手里有的相关文件全丢Codex。Codex把这些信息都保存在Workspace里,开始思考。Codex需要额外的信息完成资产台账的建立,他给我写了一个信息采集网页,非常直观简单地让人快速输入缺少的信息。Codex把资产的信息记录在了workspace里。
我问Codex,我要看看现在资产清单和总览。Codex生成了一个html网页。我跟Codex说,我希望从这几个维度看,有的资产要按照这个维度合并汇总。Codex刷新了html网页,迭代几次后,我得到了我需要的统计信息,我跟Codex说“好了,我这个数字能用了”。Codex把分析方法和我的偏好记录在了workspace里。
一天早上,我问Codex,今天有什么重要的事情吗?Codex生成了一个html网页,第一页是 to do list,列出几个需要赶快续费的资产。于是我赶紧处理完,跟Codex说,续好了。Codex把资产的状态更新到了workspace里,并且刷新了html网页。这下他告诉我全部绿灯,没有要完成的紧急事项。
Codex会写代码,但是我不需要让他写一个软件。软件、网页HTML成为日抛的东西,或者说动态变化的东西。我不需要一个固定GUI的、人类操作的资产管理系统。我需要的是给我信息、执行任务。当任务完成,网页就可以扔了。下次新任务,再重新生成就好了。但文件夹里的信息会一直累积。
Workspace成为了该类资产的管理员Agent.
(四)
下图是我目前使用的机器和软件架构。
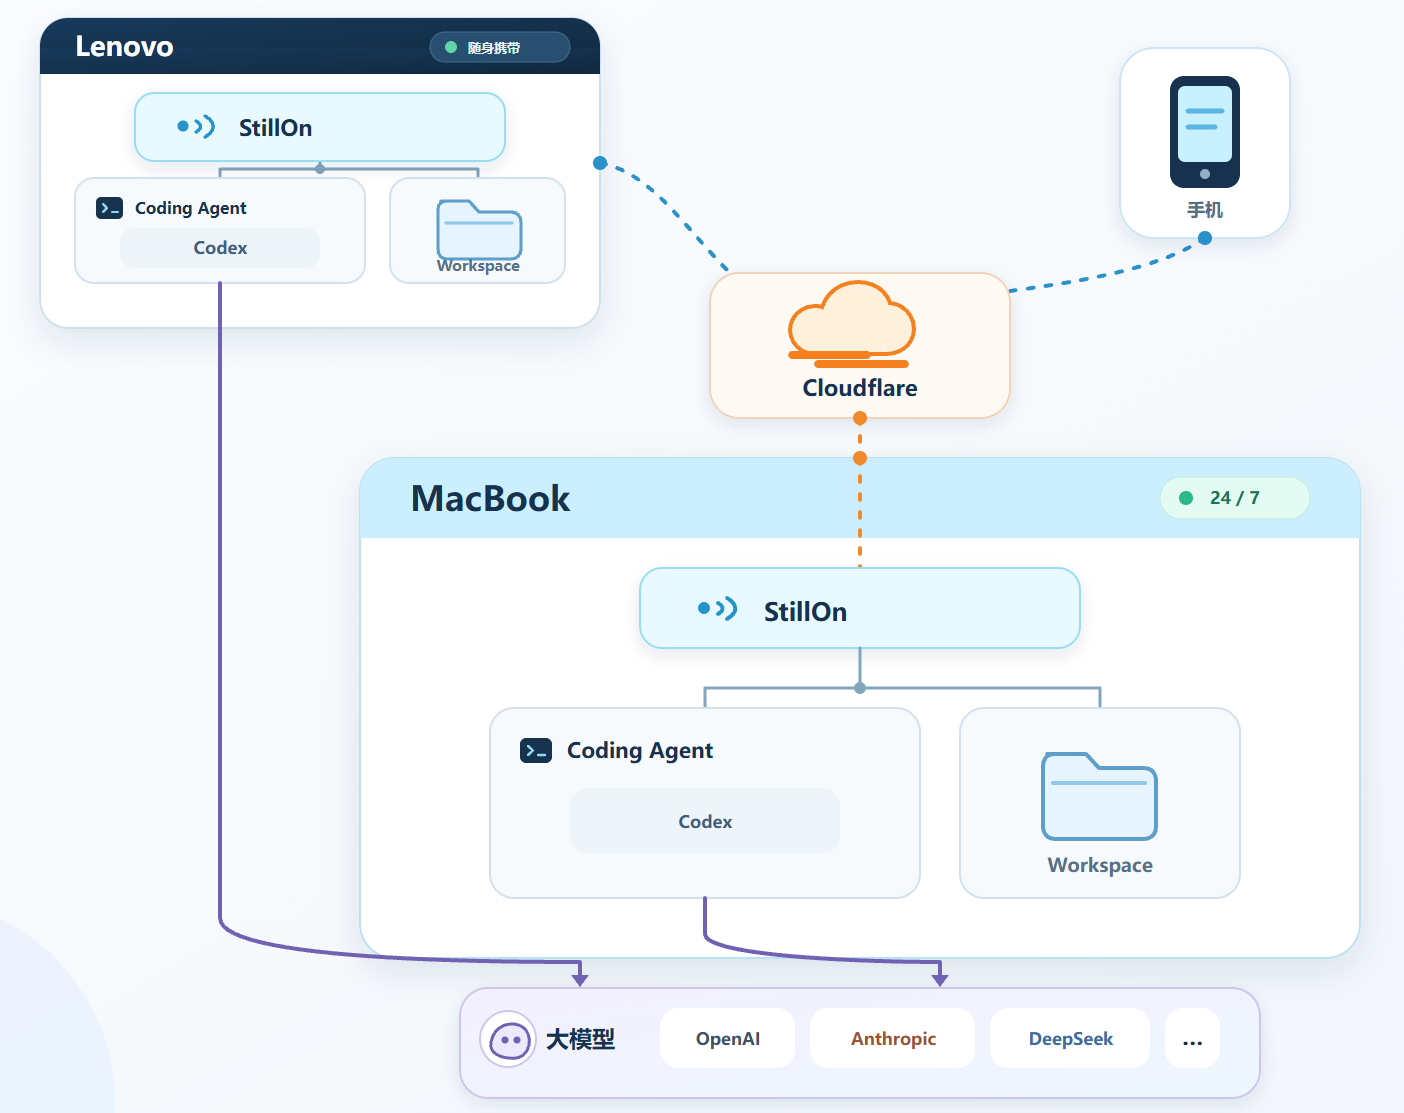
一台Windows笔记本,日常通勤工作使用;一台老旧Macbook(Mac Mini也可以),24/7开机放在桌面上。
两台电脑都各自安装了Codex, 登录的账号是同一个。
安装了一个轻量级的网页软件 StillOn,把两台机器上的 Codex + Workspace变成一个网页可操作的界面,当 Workspace 已经成为长期运行的 Agent 时,我可以在 Windows、MacBook 或手机上继续派发任务、查看进度、收取结果,而不必始终坐在那台机器前。
Cloudflare 把这个网页映射到外网,实现远程访问。
(五)
结构即智能
Andrej Karpathy在去年说过大部分人使用AI的方式,只是把它当做工具。
“大多数人与大语言模型(LLM)和文档打交道的方式,类似于 RAG(检索增强生成):你上传一批文件,LLM 在收到问题时检索相关的文本片段,然后生成答案。这种方式确实有效,但问题在于,LLM 每次回答问题时都要从头重新发现知识,知识并不会逐渐积累起来。假设你提出一个微妙的问题,需要综合五份文档中的信息,LLM 每次都必须重新寻找相关片段,再把它们拼接起来。此前的分析不会被真正沉淀下来。NotebookLM、ChatGPT 的文件上传功能,以及大多数 RAG 系统,基本都是以这种方式运作的。”
这就不是Agent原生的方式,因为就像Karpathy说的,没有迭代和积累。
没有迭代和积累的结果,就是人们只关注LLM和工具本身,有没有更强的LLM模型,Opus横空出世大家都争着用;有没有更强的Agent工具,Manus能用Computer Use,OpenClaw能接飞书,要用Dify来做RAG……但只是把这些模型和工具配齐,人们还是不觉得真的完成了任务。
为什么workspace+AI模型,比起单纯的AI模型更强更有用?
一言以蔽之,结构即智能。当workspace中的信息,以结构化的方式呈现的时候,智能程度和信息量就提高了。如果workspace里都是原始的未经整理的信息,只是靠LLM单次的加工,能提取出来的信息是有上限的,或者说,依靠LLM大模型参数和智能的提升。
workspace提供了一种大规模、离线存储、动态更新结构化数据的能力。
大规模,来源于它的存储介质,硬盘大于内存,内存大于大模型的缓存context windows。
离线存储也是硬盘的能力,让我关机之后仍然保留。因为每次更新,保存的都是跟LLM推理之后整理出的结构,本质上就是把AI模型单次推理的token所蕴含的智能给存了下来。
动态更新有两方面,一方面是电脑的能力。为什么workspace得放在“本机”上,电脑不只是提供了一块硬盘,还提供了CPU处理、硬盘读写、网络连接的功能,再上层的操作系统和应用程序提供了完成任务的能力,使得Workspace不是缸中大脑,而是可以在真实环境中跑起来,通过运行的结果获得反馈,带来的动态更新的能力。这个运行除了计算自动运行的结果之外,当然也包括人的反馈,人的反馈也要通过计算机的能力写入workspace。所以,这种动态更新即是时间层面的,今天的workspace不同于昨天的;同时也是空间层面的,我的workspace就不同于你的。
(六)
Agent化究竟带来什么好处?
我不认为是在于可以降低成本,也在于可以批量复制10000倍,而是可以做到以前都不能做、甚至不敢想的事情。
受限于资源限制,属于不能做的事情。作为创业团队,人手一定是有限的,精力要focus在最重要的事情上,导致不少有中等价值的财务和经营分析的工作就不会做得那么深,甚至就有选择放弃。但是Agent化能够解放这些中等价值的工作,开始成为可能。Agent化首先是扩展了人手和时间的边界,可以在能力范围内做更多。
受限于能力限制,属于不敢想的事情。人术业有专攻,不可能啥都懂。比如说,我要拉一个数据,得去找会写SQL的数分同学对接,数分同学要对接上游数据ETL的同学(对了,过去我是直接找财务BP的,创业公司没有luxury招财务BP啊,T.T),一来一回就受限于数分和ETL同学的排期,这还是在公司组织内部的协调还好说。再比如说,为了业务需要得有个简单的介绍网站,如果企业本身就不是搞IT的,公司里可能都没人会弄网站,业务只能去市场上找定制开发的服务商,需求对半天,成本还不低。结果可能算了,别搞网站了,搞个PPT然后转成PDF就在微信里发算了。虽然说这样也能成单,但其实背后肯定有一定的转化率损失。有了Agent化,还能完成能力范围以外的事情。
启动
什么叫“在文件夹中启动codex / claude code”?启动有两种方式。
第一种方式是在codex / claude code / opencode之类的agent GUI app中,“打开文件夹”,然后开启新对话/新session。不需要去找老的对话。
第二种方式是在Powershell之类的终端,用命令行cd到目标文件夹,然后输入 “codex –yolo” 或者 “claude –dangerously-skip-permissions”,在出现的TUI窗口开始对话。
这个启动的原理是,codex 和 claude code会在启动的时候首先读取目录中的agent.md或者类似的文件,但不会读取整个目录下所有文件。Agent.md会索引记录当前workspace的任务、目标、skills、程序脚本、可用的资源、已经做过的事情、可用的数据。AI就可以顺着agent的索引,一路摸索准确找到所需的文档和信息,类似skill的渐进式披露,而不会发生context爆炸、挤不下的情况。这样才能确保信息可以极大地被灌输进来,然后通过反馈整理链路进行知识提取。
反馈
我会经常跟Agent提供反馈。AI完成的结果,我最终出去之前我都会手工修改,不过修改后的结果,我也会存在workspace里,然后告诉AI,这是我的最终版本。一方面,AI获得了最终准确的信息,另一方面,AI可以从过程差异中,学习到这个任务的好坏评价标准和我的偏好,完成进化。这是一种半自动的反馈方式。
当任务完成到一个阶段的时候,我会让AI“请你自己做下总结反思复盘”。AI会整理Workspace中的文件,输入、中间结果和最终输出,更新索引、日志,根据失败和错误来优化Skills和程序脚本。有些密集任务,我会做成定时任务,AI都总结反思复盘下。这是一种全自动的反馈方式。
(七)
解耦的哲学
Workspace的本体就是文件夹,文件夹里包括文件、索引、日志、技能、输入输出和反馈。
Coding Agent 可以替换,基模可以替换,界面可以替换。
各自都要解耦。
Workspace之间解耦
初始化一个Agent Workspace的时候,我有时会特别加一句话:“除非经过我的同意,你只能修改、写入和删除本文件夹里的文件。本机其他目录下的文件,你只能读,不能改。”这是为了保持Workspace之间解耦、免得完成一个任务,把另一个任务搞崩了。解耦还有好处,我可以把多个Agent Workspace串联成上下游任务,上游完成任务,成果放在上游/outputs目录下;下游根据agent.md的说明,自行去上游的outputs目录中读取数据,继续下游工作。我通过这种方式,目前已经完成了一个20个agent协作网络(花了3天设计完成的),目前日常运行完全没问题,还可以一直增加功能。
Workspace和Coding Agent之间解耦
今天我们使用网页版ChatGPT,记忆就在ChatGPT里。要换到Gemini,Gemini还得想个法子让你把memory给搬过去。这就给网页版的AI模型产品一种迁移壁垒。有一天如果这个产品下线了,那记忆里的信息就都没了。
使用Workspace,无论用哪个AI,应该都能启动。区别只是有的AI能力强完成得漂亮,有的agent能力差,磕磕绊绊完成不了。
workspace跟AI的解耦,也需要管理和维护。我的具体做法是,可以让不同AI在同一个workspace里完成相似的任务,就像把工作台分别给不同的员工,观察他们的完成情况。这么做有两个目标,一是可以让我很快对不同的AI模型和Agent能力有直观的体感,二是我会希望不同的AI都能相对顺利地完成,而不是只有最顶级的agent加最顶级的模型才可以——至少是Codex和Claude Code它们俩都可以吧,这样才说明是workspace自己在提升,而不是因为某个特定基模能力提升带来的。
这样不断攒、训练workspace的信息,当有更强大的模型到来的时候,workspace可以完成更多任务,甚至跟更多sub-workspace串联起来完成更多任务。Workspace提升了当前模型的上限,而基模能力的增强也会增强workspace的能力。目前,我有一个最大的workspace,拥有GB级别规模的文件、数据、媒体文件、程序、脚本和文档了。适当的时候,这个workspace也可以让AI拆成sub-workspace,或者有些结构化数据用数据库或者RAG的方式进行存储、索引、管理,以提高workspace的效率。
Coding Agent和模型的选择
选择本地coding agent,最好用的自然是Codex和Claude Code,而且我会把电脑的full access权限都开放。Coding agent是一个软件,不是AI模型,今天叫做Harness,是不包含模型的。它其实是让LLM能够操作本机电脑的连接器和LLM翻译器,还包括让Agent持久运行真实解决问题的Agent Loop架构。各个Coding Agent背后理论上都可以接各种模型的API,Codex可以接GPT 5.6,也可以接DeepSeek.
Coding Agent这一层壳,除了Codex和Claude Code之外,还有开源的OpenCode,国内的Workbuddy和Qoder等。有的Coding Agent会跟自家的模型有绑定关系,比如说使用Codex和Claude Code就可以用订阅的方式使用GPT模型,会比第三方API使用便宜20倍。
现在大家都比较熟悉LLM模型的能力,Claude系列和GPT系列是最好的,Gemini有些掉队;国产的GLM和DeepSeek都还不错。Coding Agent这一层壳其实也有强弱之分。OpenCode是最早开源的,Manus都借鉴了不少OpenCode的harness。但Claude Code和Codex是今天世界上最好的两个Coding Agent。国产的就算了吧。
Coding Agent跟AI模型还有配合的问题。原厂官配当然是最好的,不过有时候我们也得用第三方的,比如说DeepSeek还没有推出官方的coding agent,Kimi虽然有Kimi Code可是大家还是不买单,这些也有的是接入Claude Code和ChatGPT的。但是Codex 调用子代理,接DeepSeek API就没法启动子代理(Spawn subagents),得用官方GPT模型才可以,所以DeepSeek接入Codex没有办法完全发挥DeepSeek的模型能力。
在编程任务上,国产和海外顶尖模型其实都能用。在一些普通任务上,也能够完成,最终完成质量有一些感觉,不过也能用。不过到了复杂任务、长程任务,GPT和Claude还是无法匹敌,我已经遇到不少任务国产模型绕了几个小时完全搞不定。这种情况还得等基模能力提升。
Workspace与存储介质的(半)解耦
理论上Workspace复制到另一台机器,让Coding Agent就能跑起来。我就做过在我自己电脑上开发了一个Agent让Codex把这个workspace一打包(当然Codex打包到时候会定制化地帮我去掉一些隐私信息甚至隐私数据),给我起草一段handoff提示词,我就可以把提示词和workspace打包部署到另一台机器上,也许是我的另一台24小时不关机的机器,也许是同事的机器。
之所以说半解耦,因为workspace里的很多程序和脚本会依赖本机的环境和程序,换了一个机器很可能跑不起来。不过没关系,从信息论的角度来说,这些信息是不需要的,新的机器有新的环境,他的Coding Agent会修复的。
发表回复