首先声明一下,我依旧认为“AI检测AI”是一种西西弗斯的努力,不可能有一种算法或模型能从根本上解决这个问题(一方工具这种不算)。在ChatGPT出现以后,我定期在做「AI检测AI」的跟进和研究,只要有新的模型,我就会测一遍,并且在去年11月写了一篇文章《AI检测就是个骗局》。
我写道:“研究发现,AI生成技术一旦在语言风格上模仿人类更自然,或通过改写工具进行去AI化处理,几乎是无法识别的。” “AI检测AI,这是一个从根本上就不成立的手段。”
2026年春节后,我又做了一遍检测实验,结果出乎意外的好!我刚刚用上codex的时候,我做了一个检测AI的agent。输入待检测的文章后,会生成一个百分比表示AI率,同时会给出具体AI还是人类写作概率的证据。然后我用了简单的迭代方式,让agent自己发掘AI pattern。我发现用很少的数据竟然显著提高识别准确率。Agent自我迭代优化太牛了。
如下图所示,平均绝对偏差指的是检测分数与真实值相差多少,再取平均,用“百分点”表示,越低越好。“准确率”指的是“方向判断准确率”:以 50% 为分界,判断文章是人类主导还是 AI 主导,再用方向判对的篇数除以总篇数,越高越好。
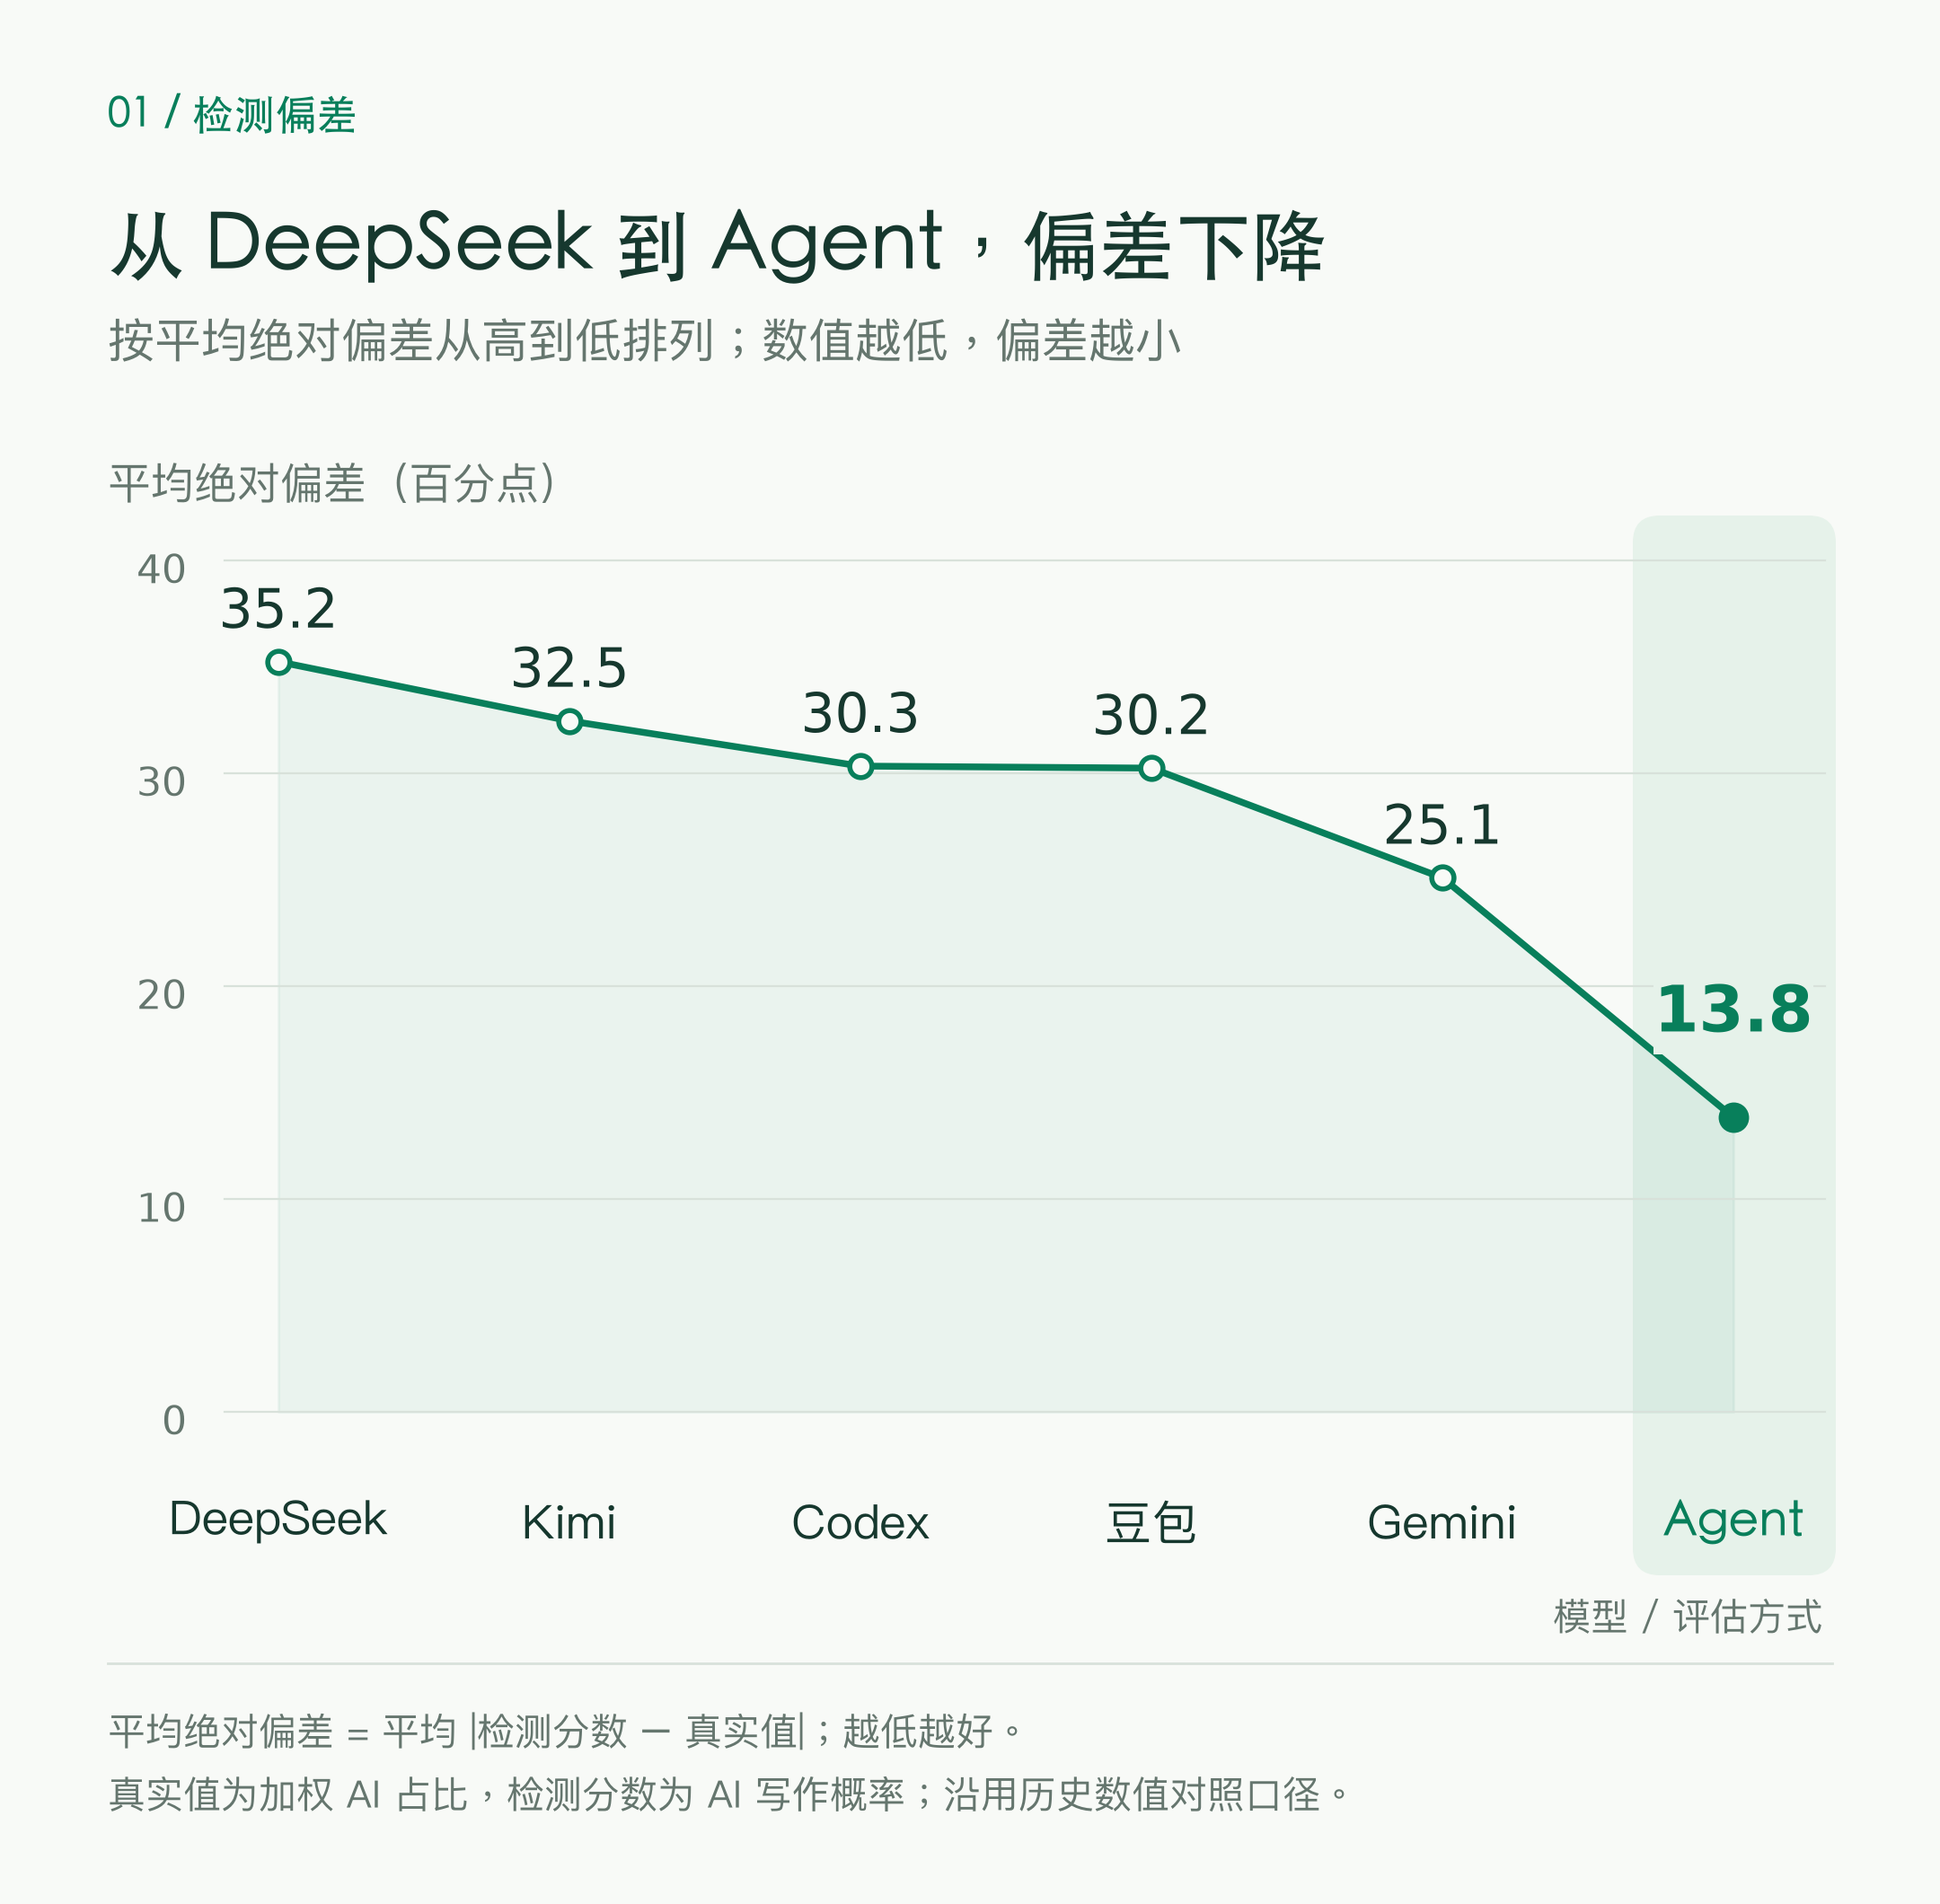
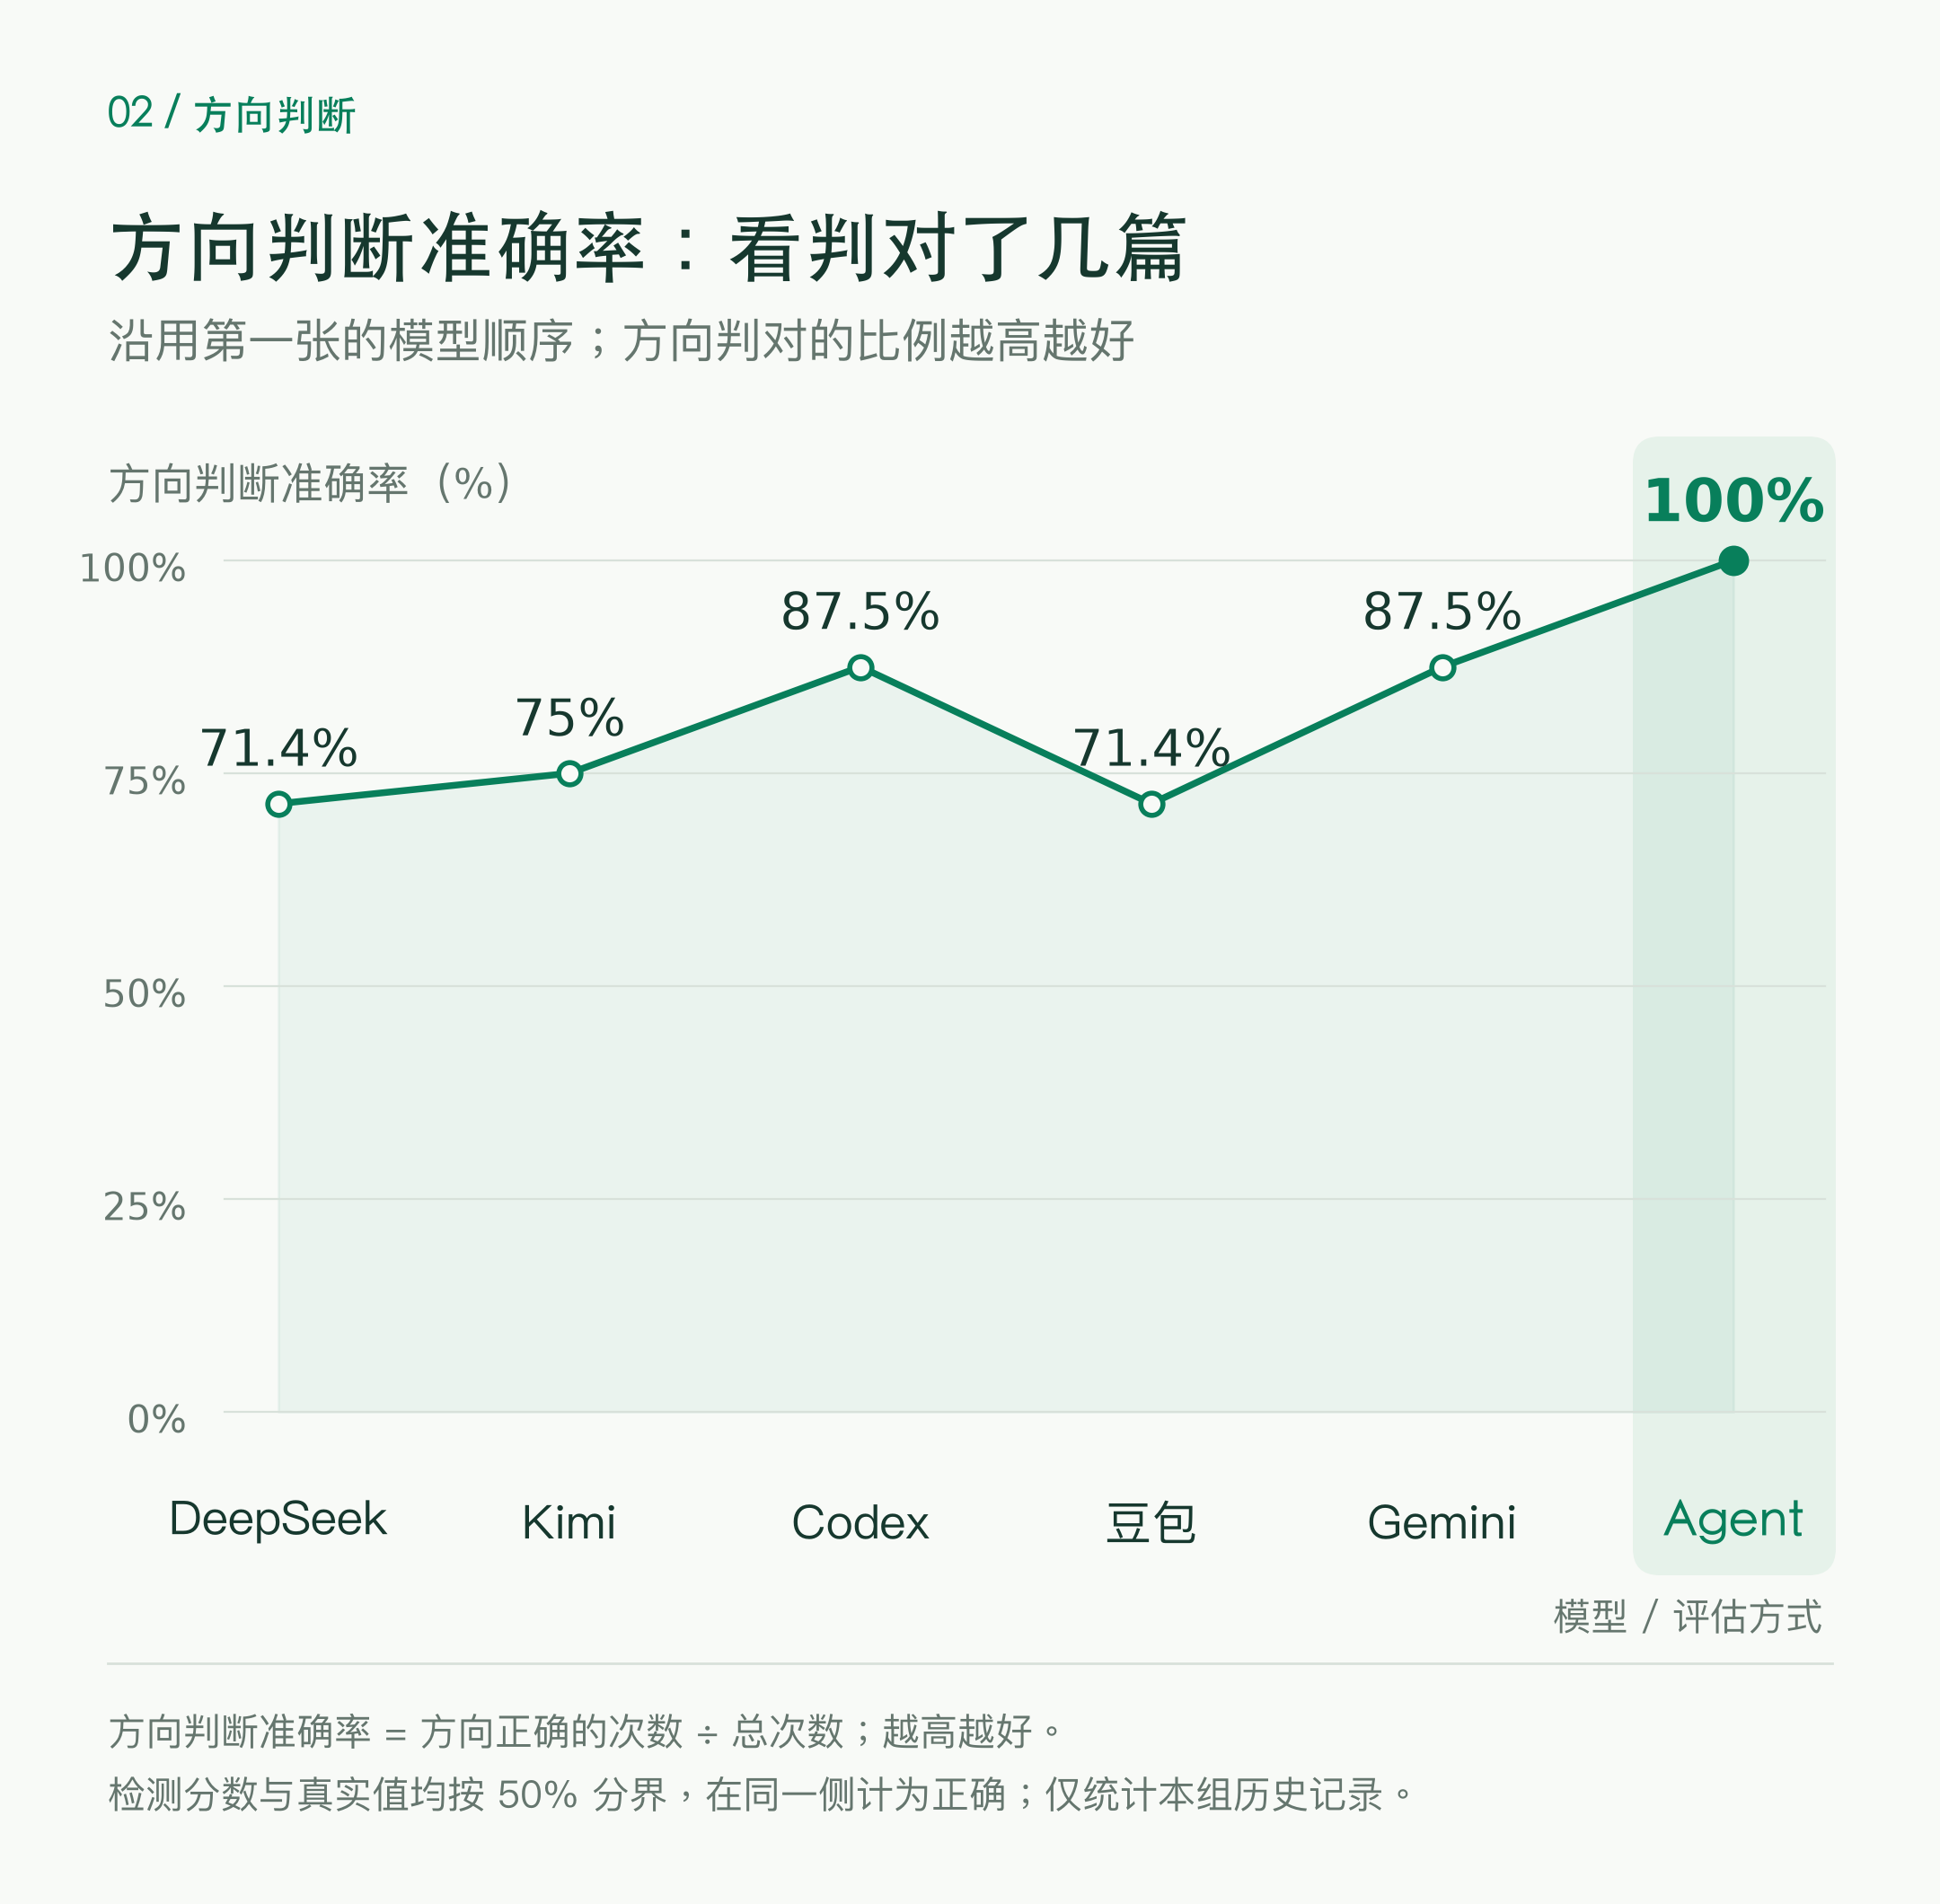
按这两个指标看,这个Agent的优势同时体现在数值和方向上。第一张图中,Agent的平均绝对偏差为13.8%,明显低于所有参与对比的通用模型;相比其中表现最好的 Gemini(25.1%),偏差值低了将近一半。第二张图中,Agent的方向判断准确率为100%,其他模型为只有八成左右的准确率。这意味着,在这批文章上,Agent的分数更贴近真实标注,最终方向也判得更准。
这个Agent是这么训练的。
(a) 训练与分析
让Codex直接开始分析一些文章,判断它是AI写的还是人写的。这一步是盲测。要求它必须把理论证据(即证明是AI写的证据,或是证明是人写的证据)列出来。
(b) AI率计算
公式为:AI写的字数 ÷ 整篇文章的字数 = AI率。
如果中间有一段文字是人跟AI一起共创的,比如AI先写了一部分,然后人在中间大规模地去 prompt,这就属于模糊地带。最开始我没有想过这种情况,但后来我就简单处理,就算作0.5个字是AI写的,0.5个字是人写的。
(c) 提供真实值的反馈
如果能确定知道创作过程的文章,我会反馈Ground Truth给 Codex,精确地告诉它哪些字是AI写的,哪些是人写的,哪些字是AI跟人共创的,然后让它据此计算AI率的Ground Truth; 我还会对它提出的几个论据做反馈,告诉它实际上你的论据那个判断对了,哪个错了。
(d) 让AI自己总结反思与归纳,沉淀成AI检测的方法,记录在 MD 文件中。
大概迭代了非常少的文章(大概个位数)进行训练之后,就形成了这样一个Agent。一开始的准确率跟通用模型类似,很快就大幅上升了。
这个Agent给我两个aha moment:第一是准确率确实眼见提升;第二,它的分析过程也给我非常多的启发,我突然意识到,原来有些AI的pattern是这样,有些人类的缺点其实是优点。
不少写随笔类型公众号的朋友对这个工具很感兴趣,感兴趣的点有几个:
(1) 我用这个agent抓了一些传统媒体的内容(不点名了),发现有的媒体的内容都是AI,有的(比如小晚)AI率超低,跟不少人个人体感还挺match的,顺势引起吐槽和讨论;
(2) 他们听到我从Agent的分析过程中收获了一些,反过来他们也想对自己的内容有所aware;
(3) 有的人希望:啊既然能检测AI了,那我就能训练一个没有AI味的公众号写作Agent了。
我在分享的时候,顺势跟这些朋友讲,你们也可以拿过去的文章测一测,同时检测的结果share出来看看。其实就用人工的方式搜集反馈来进一步训练提高Agent。
我从这个过程得到一些收获。
1、今天我们仍然会感受到AI味,有的人感受强烈,有的人感受得比较弱,其实还是因为AI生成的文章仍然有一定的pattern,仍然是统计分布有偏的。这是AI检测准确率之所以还能提升的底层基础。
2、输出的结果不要只有一个百分比。对我来说,看到百分比值的作用远远小于后面的分析过程。不少朋友给我的反馈也是如此,对他们后续写作提供更多洞察和慰藉,他们看到自己写作的价值,也不再跟AI瞎搏斗或者盲信。
3、只有随笔类型文章检测效果好。检测AI剧本一塌糊涂。
4、我仍然认为“AI检测AI”是一个西西弗斯的努力,就像永动机一样不可能根本解决。从正向来说,如果AI有pattern,理论上AI总能学会避开这个pattern。就像Sarah Guo所说的,只要是能衡量的东西,就能针对它进行训练。从反向来说,AI也在塑造人和社会。我发现,现在不少年轻人,说的话也越来越AI味了。今天的AI味也许就是明天的人味,这是动态的。从长期来看,Agent今天积攒的规则/knowhow/能力(甚至把这种能力训练进模型的权重)带来的领先优势一定会消失,迟早的事儿。
5、但是,即使西西弗斯的努力在根本上是无意义的,在当下仍然是有意义的。在现在,我的检测就能做到比通用水平显著地高。其他人当然也可以学习我的pattern,但是那已经是以后了,你学到我的pattern的时候,我已经不是今天的我了,AI已经不是今天的AI,人也不是今天的人——或者换句话说,你一直在学昨天的世界pattern,刻舟求剑,抽刀断水。
时间是一个事物产生意义的的巨大变量。意义来自于当下。所有题目最终都会做出来的,但你要在考试的那2小时内做出来才有意义。社会学经济学也是如此,你当然可以事后总结历史规律,但是最珍贵的是在事情发生当时,你就能看到这个规律并且采取行动。人们批评凯恩斯主义的财政政策in the long run是无效的,凯恩斯回答:In the long run, we are all dead.
6、评估跟生成是两种截然不同的能力。会评估不代表会生成。 我尝试过让写文章的Agent自动接入AI检测,然后给他的目标是:「请你修改文章,目标是把AI率优化到25%以下」。结果是,AI率确实可以稳定下降到25%以下,但是文章内容全丢了。写文章的Agent为了规避AI味,删掉了很多有意义的文字,变成意义不明的意识流,结果我得到一个AI味很低的疯子。
一方面是reward hacking导致的。另一方面,生成能力和评估能力的训练或者说优化方法也是截然不同的。获得评估反馈是优化生成能力的必要条件,但并不充分。就像欣赏莫奈的美术评论家,他的眼睛很有审美。但他画不出莫奈的画,因为画画的关键是要训练他的手,不只是靠眼睛和审美力。
发表回复